检查左右角色是否保持一致
照片 1 对应左侧表演者,照片 2 对应右侧表演者。动作过程中分别对比两人的五官、发型和服装。两张独立、光线清楚的照片能提供可区分的视觉参考,但不保证模型保留每个细节,也不保证人物间距始终不变。
 ReelMorph
两位表演者,一支麦克风
用两张照片,让两个人站上橙色摄影棚,在悬挂麦克风前完成双人表演。生成无声 Hotel Lobby AI 同款视频,下载后再去 TikTok 添加官方原声。
这是带声音的示例片。你的生成结果是无声视频,请下载后去 TikTok 添加官方原声。
认识这个趋势
Hotel Lobby AI 同款是双人网络热梗,视觉来源是 Quavo 与 Takeoff 在 A COLORS SHOW 演绎 HOTEL LOBBY 的橙色布景。虽然名字里有 Hotel Lobby,但画面是极简摄影棚,并非真正的酒店大堂。
照片 1 用于左侧人物,照片 2 用于右侧人物。预设场景描述安排橙色摄影棚、悬挂麦克风、双人动作与全身构图。可选 5–15 秒,生成结果不含音乐、人声或音效。
橙色布景和双人互动让画面简洁鲜明。用有权使用的照片安排两位角色,探索不同穿搭和人物组合。
清楚安排两个角色
每位人物各准备一张照片,确认左右角色后生成无声表演。检查并下载成片,再单独添加音轨。
每张图只放一个人,脸部清楚、服装可辨,两张图的光线尽量接近。全身照有助于明确裤装和鞋子;上半身照也能使用,但缺失的衣着需要 AI 补全。避免遮脸、重度滤镜和多人合照。
照片 1 对应左侧人物,照片 2 对应右侧人物。支持 JPG、PNG 或 WebP,每张不超过 10 MB。确认拥有两人的肖像使用许可,再按预设场景描述生成。
选择 Seedance 2.0、5–15 秒、分辨率和画面比例,默认时长为 14 秒。确认页面实时报价后开始生成。示例片即使有声音,生成结果仍是无声视频。
检查两人的身份、左右位置、全身构图、手部和悬挂麦克风。下载无声视频,再去 TikTok 添加账号可用的官方原声。调整音轨起点并完整预览;节拍和口型不保证完全同步。
生成的成片不含音乐、人声或音效。下载后可在 TikTok 添加账号可用的官方原声。
从头到尾查看两个人,确认脸部、手部、间距和全身构图,再保存视频。
在 TikTok 搜索 Quavo、Takeoff 的 HOTEL LOBBY,核对艺人或官方发行来源,试听后选择账号可用的声音。
将无声成片上传至 TikTok,添加声音;若编辑器支持,调整音轨起点,完整预览后再发布。
声音可用性因账号与地区而异。原曲不可用时,请选择可用且有权使用的音轨。添加声音不会重做口型,也不保证每个动作都准确卡点。
热梗背后的表演
视觉参考来自 Quavo 与 Takeoff 在 A COLORS SHOW 演绎 HOTEL LOBBY 的表演:两位表演者、纯色橙色摄影棚和一支悬挂麦克风。链接指向 COLORS 的来源表演,并非 ReelMorph 生成结果。
COLORS · Quavo & Takeoff — HOTEL LOBBY ↗AI 二创在熟悉布景中重新安排两个角色,你上传的照片决定人物组合。分享时请注明灵感来源,并标明视频由 AI 生成;ReelMorph 与艺人及 COLORS 无关联。
独立创作工具,与原表演者无关联。
以下画面来自现有示例片,展示橙色布景、悬挂麦克风与双人互动,并非上传照片生成的结果。生成时会引导模型采用更宽的头到脚全身构图。
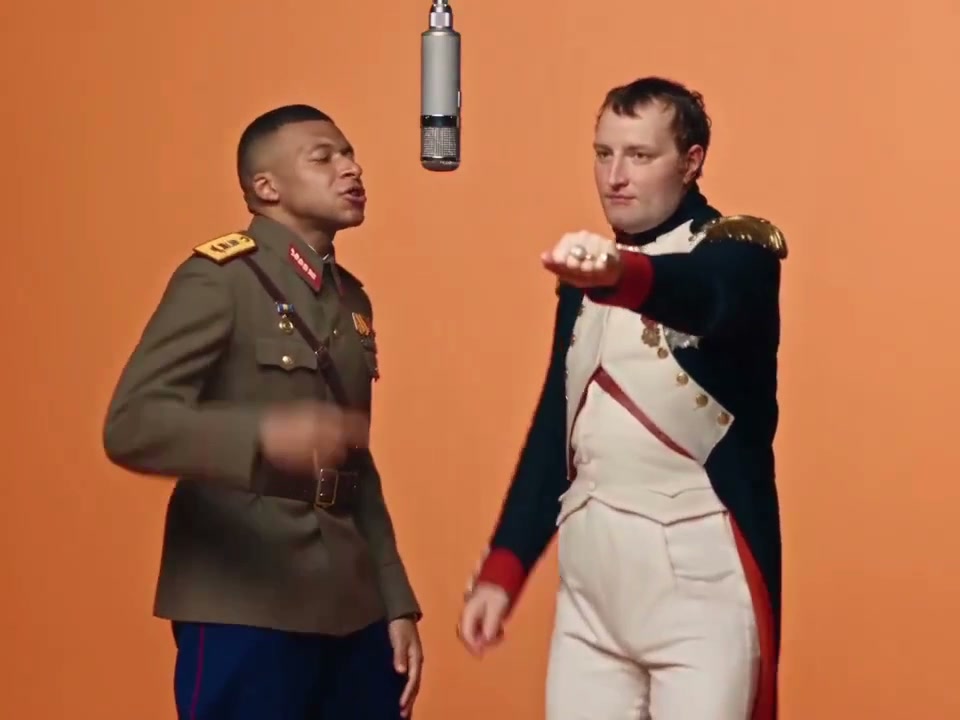
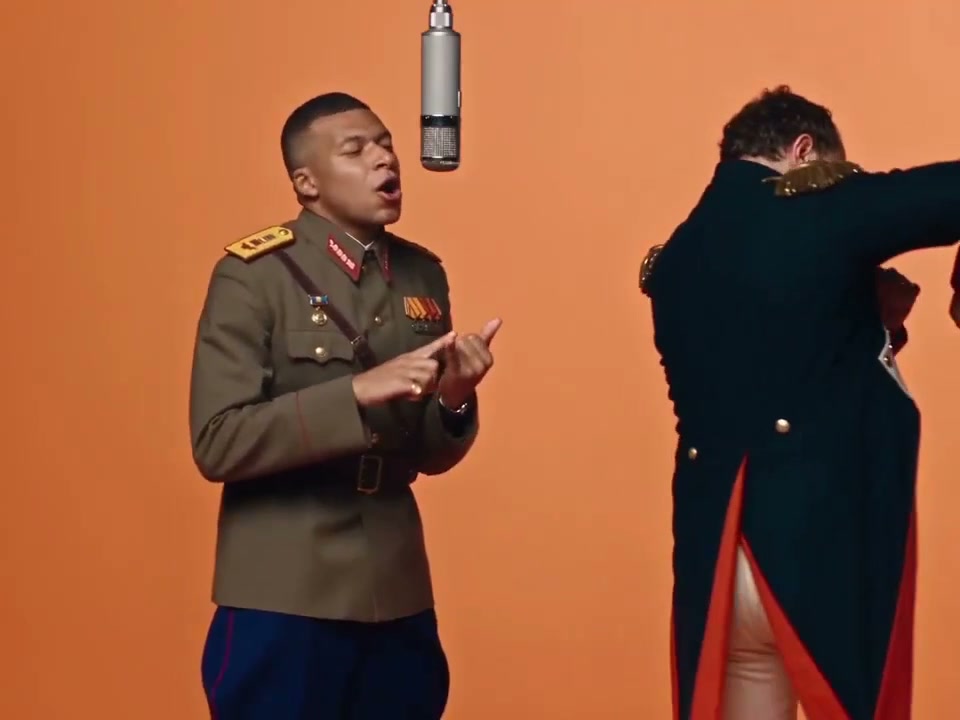
分别使用两张面部清晰、人物大小相近、服装可辨的照片,全身照能提供更多裤装和鞋子细节。查看完整成片中的两个人:身份、站位、动作和构图可能变化。后期添加音轨不能修复画面。
Hotel Lobby AI 同款由橙色布景、悬挂麦克风和两位表演者构成。简洁的场景会让角色变化更显眼。看完整段视频时,需要同时关注两个人,尤其是手势交叠处,不要只检查更靠近镜头的那一位。
照片 1 对应左侧表演者,照片 2 对应右侧表演者。动作过程中分别对比两人的五官、发型和服装。两张独立、光线清楚的照片能提供可区分的视觉参考,但不保证模型保留每个细节,也不保证人物间距始终不变。
这个场景以从头到鞋子的全身表演为目标。尤其在上传照片未包含下半身时,检查鞋子、脚部和下装是否合理。留意手部经过麦克风的动作,以及两人靠近时是否发生肢体粘连。更换画幅会改变两位表演者可用的构图空间。
Hotel Lobby AI 同款生成 5–15 秒的无声片段,默认 14 秒。后期添加账号可用的声音时,先选择想使用的片段,再检查完整剪辑。样片的音轨不会包含在你的生成结果中;添加歌曲也不能修正已有口型或被裁掉的手势。
如果需要单人动态照片,或橙色布景以外的场景,可以到自定义生成器上传照片并描述动作。
创建 AI 视频不是。趋势名称来自歌曲,标志性场景是 A COLORS SHOW 的极简橙色布景。
需要。每位人物各上传一张照片:照片 1 对应左侧表演者,照片 2 对应右侧表演者。
不包含。此特效生成无声视频,没有音乐、人声或音效。示例视频可以播放已有音轨,但你的生成结果没有声音。请下载后在 TikTok 添加账号可用的官方原声。
后期添加音轨不会改变已经生成的嘴部动作。可以调整声音起点,并完整预览动作与节奏。
可选 Seedance 2.0、模型支持的分辨率、9:16 / 16:9 / 1:1,以及 5–15 秒整数时长,默认 14 秒。生成前显示实时报价;不再提供“原创说唱”模式。
两张有权使用的单人照片即可。页面已准备好场景描述,上传照片并确认设置后开始生成。教程会介绍选图、检查成片与添加声音的方法。