检查主角在转头时是否仍可辨认
分别查看开场、转头和结束姿势,对比眼睛、脸型、头发与服装。即使第一帧看起来合适,强烈彩色灯光也可能遮住后续细节。如果身份特征变化明显,可以尝试更清晰、遮挡更少的肖像,不要只依赖提高分辨率来修复。
 ReelMorph
一张照片,主角是你
用一张照片成为表演主角。生成 15 秒无声 Bulin 47 AI 同款视频,下载后去 TikTok 添加官方原声。
这是带声音的示例片。你的生成结果是无声视频,请下载后去 TikTok 添加官方原声。
认识这个特效
Bulin 47 AI 同款是街头即兴说唱风格的照片动画特效。上传一张有权使用的人像,按预设场景描述生成包含手势、红色灯光和周围人群的 AI 表演短片。
照片提供人物的脸部、发型与服装信息,预设场景描述安排表演动作、构图和节奏。生成的 15 秒视频不含音乐、人声或音效,下载后可去 TikTok 添加官方原声。人物细节和动作可能因生成而变化。
吸引力来自熟悉表演与意外主角之间的反差:短片中的表情和动作容易让人理解,也适合用不同人物进行二次创作。把自己或朋友放进同一种表演情境,会带来有趣的互动和分享话题。不过,使用同一模板并不意味着每条视频都能成为爆款。
让照片中的你成为主角
准备一张清楚的人物照片,使用预设表演场景生成 15 秒无声视频,再到 TikTok 添加官方原声。
推荐光线充足、正面或轻微侧面的肖像或上半身照片。脸部不要被遮挡,头部和肩膀尽量完整入镜。避免合照、拼图、重度美颜、运动模糊,以及手挡住面部的照片。请使用你有权制作动画的照片;这个特效不要求必须上传全身照。
上传一张不超过 10 MB 的 JPG、PNG 或 WebP,检查人物是否清晰,并确认拥有图片和肖像使用权限。页面已提供场景描述,确认设置后即可生成。
选择 Seedance 模型、分辨率与画幅后,确认实时报价。时长固定 15 秒,关闭音频生成;结果区域显示真实任务状态。
完整查看表演,检查脸部、手势与构图。下载无声视频并上传至 TikTok,选择艺人或原作者发布的官方原声。调整声音起点,预览后再发布;节拍和口型不保证完全同步。
下载的视频不含音乐、人声或音效。检查画面后,在 TikTok 中完成配音轨这一步。
查看完整的 15 秒成片,在下载链接有效时保存到手机。
在 TikTok 找到 Bulin 47 或 Kevin Wai 官方账号发布的原始表演,打开声音页面,在可用时收藏原声。核对发布者与录音内容,不只看声音标题。
将视频上传到 TikTok,在“添加声音”中选择收藏的官方原声。调整起点,听完整段并检查动作后再发布。声音可用性和按钮名称可能因版本而异。
后期加声音只会改变音轨,不会重做口型。如果账号无法使用原声,请选择可用且有权使用的音轨,不要期待口型自动匹配。
认识趋势背后的创作者
原始表演中的两位主角是多米尼加艺人 Bulin 47 和创作者 Kevin Wai。据 MARCA 报道,在西班牙一家餐厅外,Kevin 带着音箱播放 dembow 节拍,Bulin 则以即兴说唱和舞蹈回应。
MARCA ↗创作者用自己的照片制作 AI 表演短片,探索不同人物与街头场景的搭配。分享时请注明灵感来源,并清楚标注视频由 AI 生成。
独立创作工具,与原表演者无关联。
以下截帧来自现有示例片,展示主角、红色灯光、人群和前景手机。这些是示例画面,不是上传照片后的生成结果。
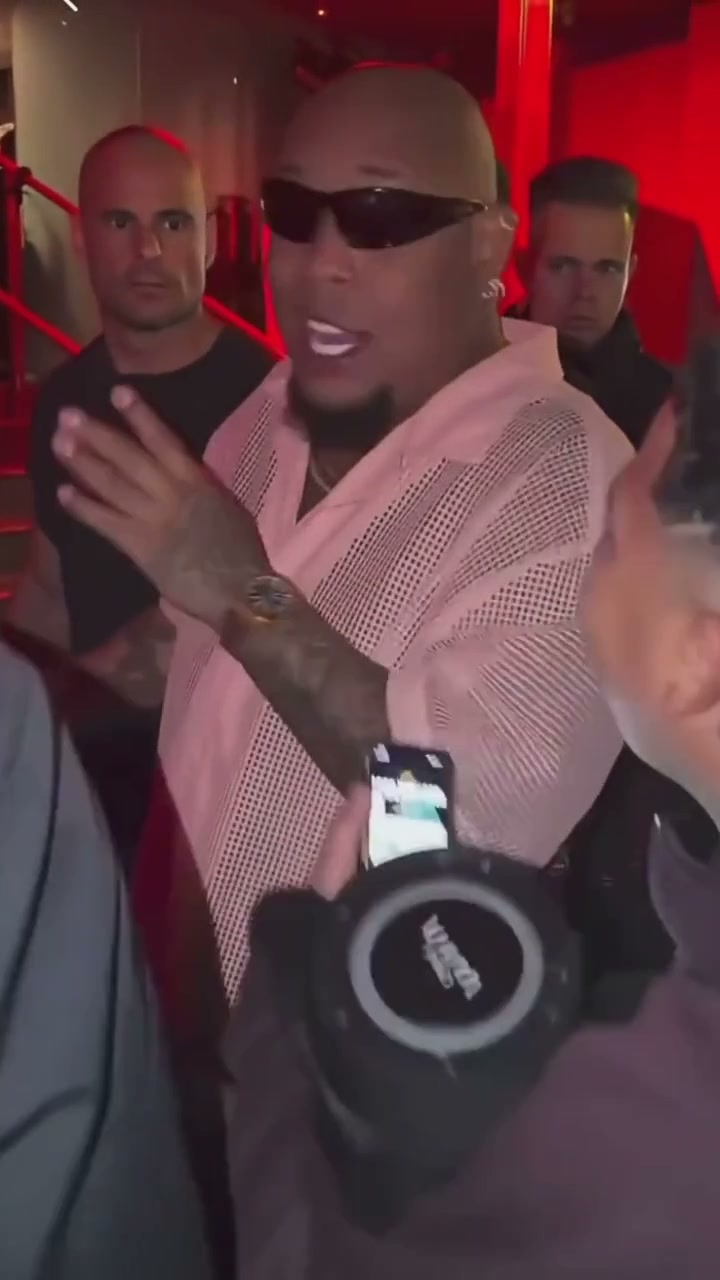
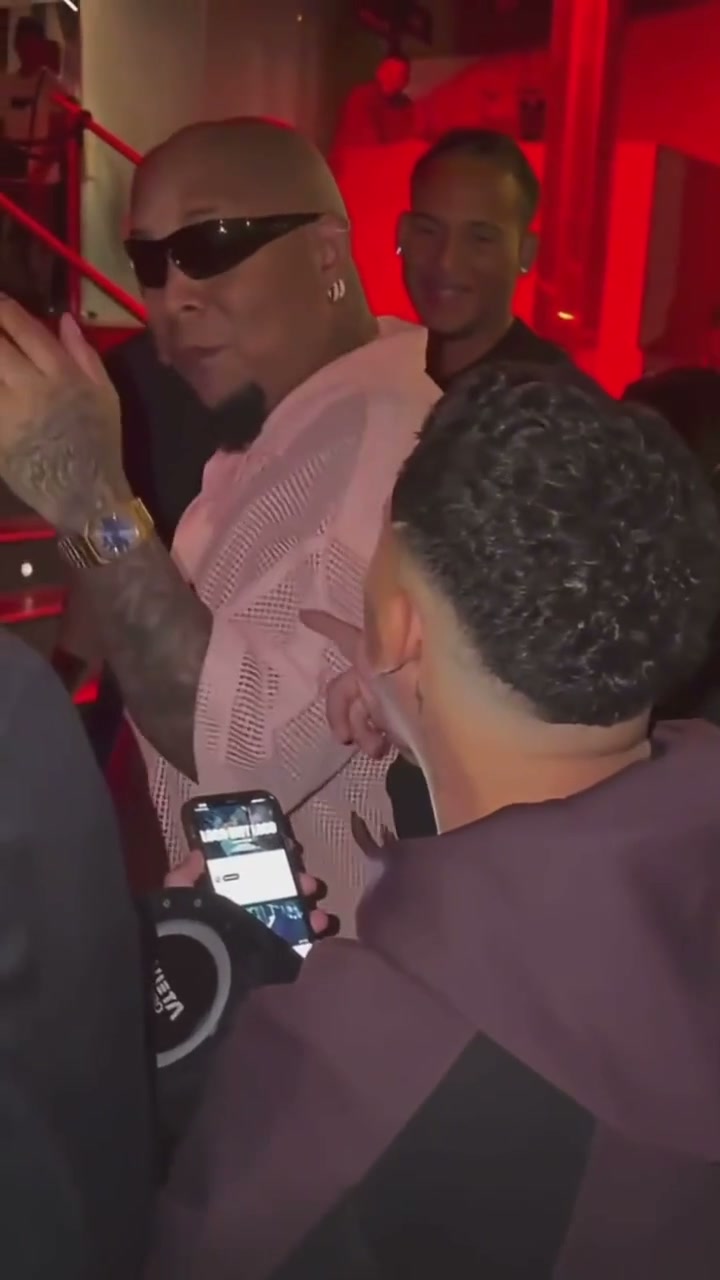
请选择光线充足、正对镜头的单人照片,确保脸部与上半身清晰可见。AI 可能改变背景细节或未能准确还原人物,分享前请检查结果。
Bulin 47 AI 同款的识别点是单人表演、富有表现力的手势、近处围观人群和红色街头灯光。先通过样片理解构图,再检查自己的角色在动作中是否清楚可辨。样片提供参考,不代表生成结果会拥有完全相同的五官或手势。
分别查看开场、转头和结束姿势,对比眼睛、脸型、头发与服装。即使第一帧看起来合适,强烈彩色灯光也可能遮住后续细节。如果身份特征变化明显,可以尝试更清晰、遮挡更少的肖像,不要只依赖提高分辨率来修复。
在较大幅度的手势处暂停,检查手指、手腕及人物交叠。周围人群属于生成场景,并非你可以逐一上传照片控制的角色。用于个人分享时,主角表现清楚比复刻样片中的每张背景面孔更有意义。
Bulin 47 AI 同款生成固定 15 秒的无声视频。下载后选择账号可用的声音,并从头到尾检查节奏。调整音频起点只能改变时间对齐,不会重新生成口型,也不能修复变形画面。保留一份无声原片,方便后续编辑。
如果想要安静的动态肖像或不同场景,可以在照片转视频生成器中描述自己的动作。
创建 AI 视频上传的人像与预设场景描述共同用于生成 AI 表演视频,包含人物手势、红色灯光和人群互动。生成后请检查人物细节与动作是否自然。
一张有权使用的清晰人像即可。页面已提供场景描述,选择参数并确认积分费用后开始生成。
不包含。ReelMorph 生成的是无声视频,没有音乐、人声或音效。请下载后去 TikTok 添加官方原声。示例片本身有声音,不代表生成结果会附带同一音轨。
后期添加声音不会改变已有的嘴部动作。调整声音起点可以改善整体节奏,发布前请完整预览。
使用一张有权用于动画制作的成年人照片,确保脸部和上半身清楚可见。供应商仍可能根据自身规则拒绝写实人像。这个预设没有宠物版或主题人群选项。
费用随所选模型与分辨率变化,以提交前的实时报价为准。15 秒是成片时长,等待时间取决于供应商队列。